国产GPU的“追平”时刻:天垓300在推理赛道逼近H200
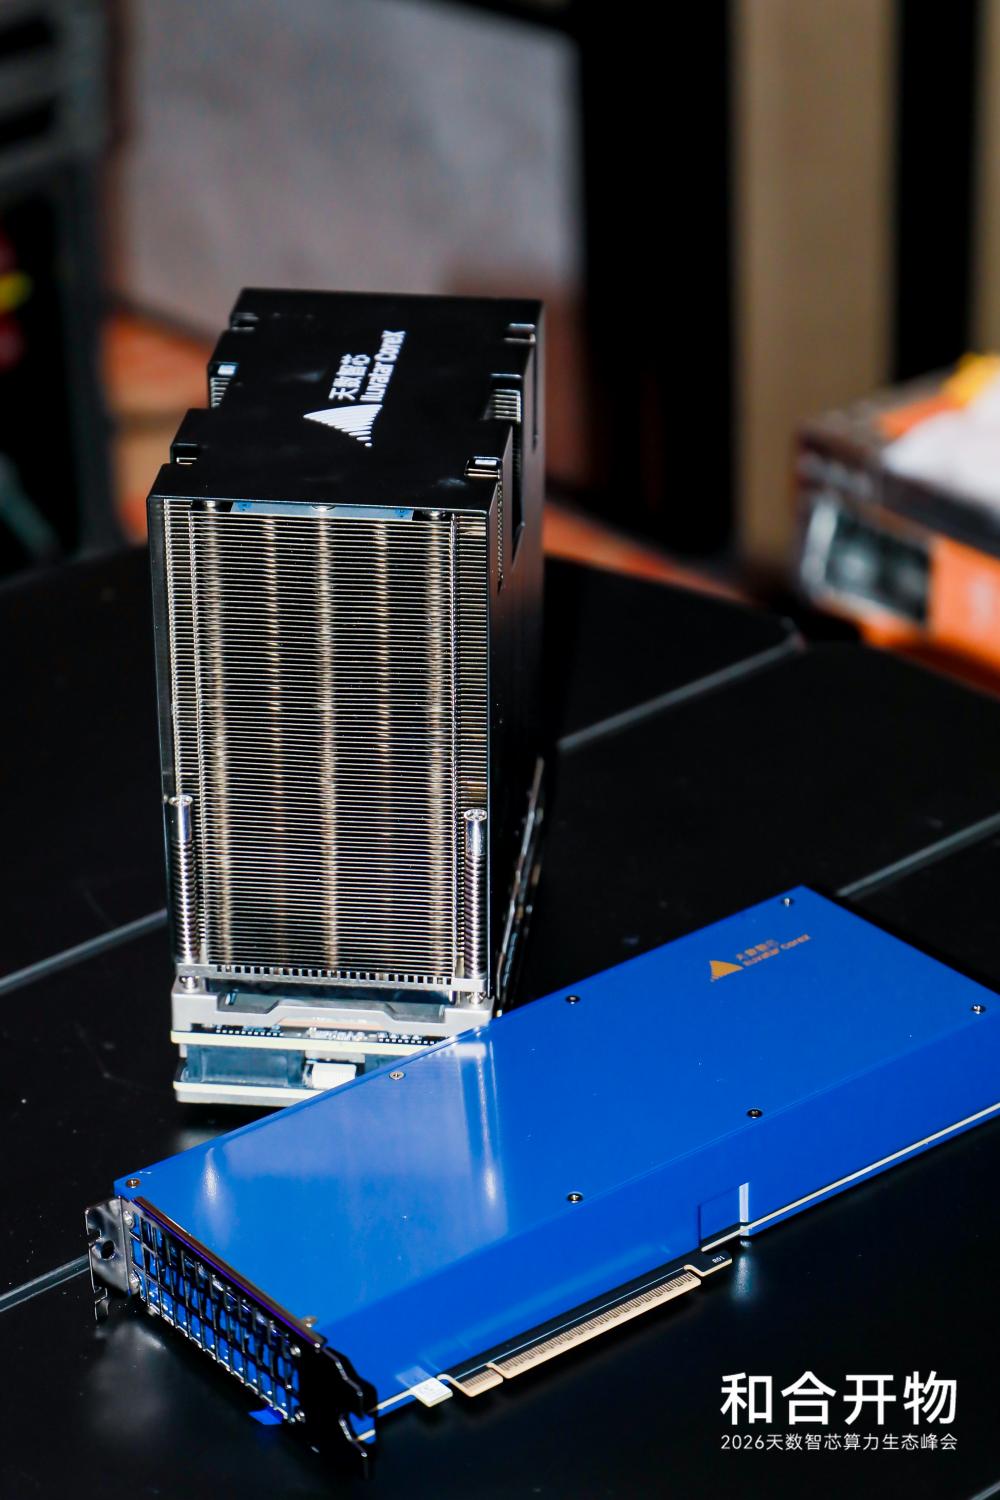
据2026年10月底多家媒体报道,天数智芯的天垓300在第三方实机测试中,于特定大模型推理场景下,性能追平并略微反超英伟达H200。消息引发关注的关键在于:这不是理论峰值算力的纸面对比,而是在真实部署链路中测得的实际有效吞吐。
不过,这是一次有明确边界的“追平”。它标志着国产通用GPU在大模型推理这一核心场景中,已经具备与H200正面竞争的实力;但并不意味着在所有维度上全面超越。
一、实测数据:哪些指标追平了?
最核心的数据来自上海仪电在2026年7月完成的第三方实测。在典型的大模型预填充—解码分离(PD分离)部署下,天垓300折算单卡的整体端到端吞吐达到H200的1.05倍。这被官方定义为“国内首个实测性能达到H200水平的通用GPU”。
除了整体吞吐,天垓300在多个具体推理场景中也表现突出:
| 测试场景 | 天垓300相对H200表现 |
|---|---|
| 整体端到端吞吐(PD分离部署,折算单卡) | H200的1.05倍 |
| 64K长上下文Attention | H200的1.05倍 |
| GLM-5.3模型64K规模MoE吞吐 | H200的1.15倍 |
| Agent首字延迟(8K—128K长上下文) | 延迟降低约10%—30% |
| 推荐系统推理吞吐 | 提升21% |
| 推荐系统轻量计算时延 | 降低26% |
| 多模态生成推理吞吐 | 提升2%—5% |
| 满负荷运行步时波动 | 0.43%,低于对比Hopper方案的0.76% |
从数据看,天垓300的优势集中在长上下文、MoE模型、低延迟Agent、推荐系统和高负载稳定性等推理侧场景。尤其是在满负荷运行时,更低的步时波动意味着更好的长时高负载稳定性,这对商业化部署尤为重要。
二、“追平”的真正含义:实际吞吐,而非峰值算力
理解这次成绩,需要抓住三个关键词。
第一,比的是“实际吞吐”,不是“理论峰值”。
天数智芯明确表示,比较的不是理论峰值TFLOPS,而是在特定模型和部署条件下,整条推理链路的实际输出能力。换句话说,天垓300的优势在于推理效率,即“算得值”,而不是纯粹的算力规格。
第二,场景聚焦于“推理”。
现有对标测试主要针对大模型推理,如文本生成、Agent、推荐系统等。虽然也提及支持混合训练,但尚未有大规模训练性能对标数据。H200作为通用GPU,在训练领域的生态和性能依然是强大标杆。
第三,系统级优化是关键。
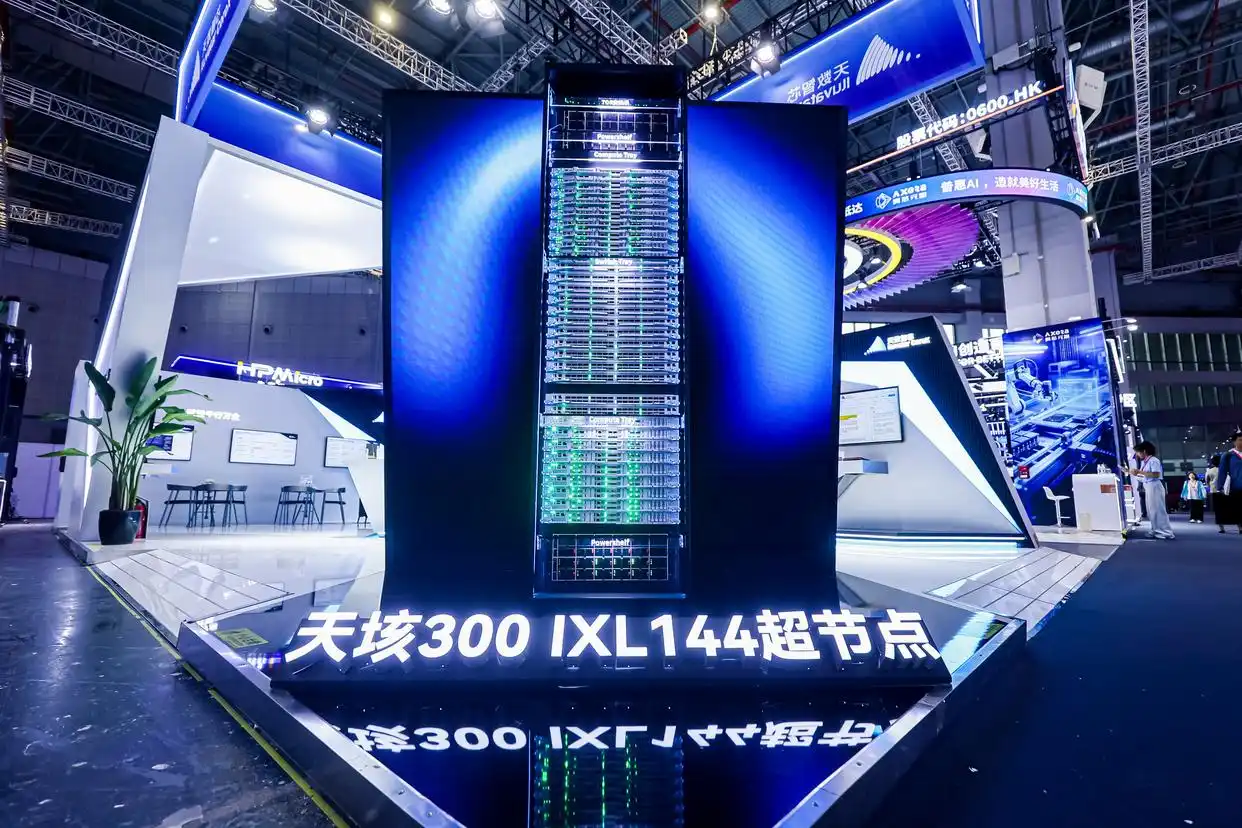
这一成绩部分得益于PD分离等系统级部署优化。天垓300的价值不仅在于单卡,更在于其通过IXL144超节点——单机柜集成144颗GPU——以及异构计算(GPU+XPU协同)提供的整体解决方案。据测算,其超节点方案每百万有效Token成本较国际主流方案可降低约40%,这在商业化落地中是关键优势。
三、客观看待:不是全面反超,而是精准超越
在肯定成绩的同时,也要看到“追平”的限定条件。
H200在训练性能、CUDA生态的成熟度与广泛性、全球部署经验上仍有深厚积累。天垓300的“追平”,是在大模型推理效率这个特定赛道上实现的精准超越,而非全面的技术代际反超。
更准确地说,天垓300证明的是:在推理场景中,国产通用GPU已经从“能用”迈向“好用”和“有竞争力”。它能在实际吞吐、长上下文、MoE、低延迟和成本效益上与国际主流方案正面较量,但在生态广度和训练通用性上,仍需持续积累。
结语
天垓300的实测表现,是国产GPU产业一个里程碑式、有明确适用边界的成就。它把竞争焦点从“峰值算力数字”拉回到“实际有效吞吐”和“每Token成本”,这恰恰是大模型商业化最关心的指标。
“追平H200”不是终点,而是一个更务实的起点:国产GPU已经在推理赛道证明自己,接下来要做的,是把这种竞争力扩展到更完整的生态和更广泛的场景中。